
整理了 README 與專案,讓讀者知道怎麼啟動 Bot,以及各個檔案負責什麼。今天來到系列最後一天,把前面完成的功能串成一條 Demo 路線。
這次要展示的重點,是使用者提出需求後,各個 Agent 如何從不同角度回應,需求改變後如何調整,以及最後怎麼把決定權交回使用者。
如果需求只有「做一個簡單網站」,Agent 很容易都給出相近的建議。展示用專案需要有明確目標,也要有足以影響方案的限制。
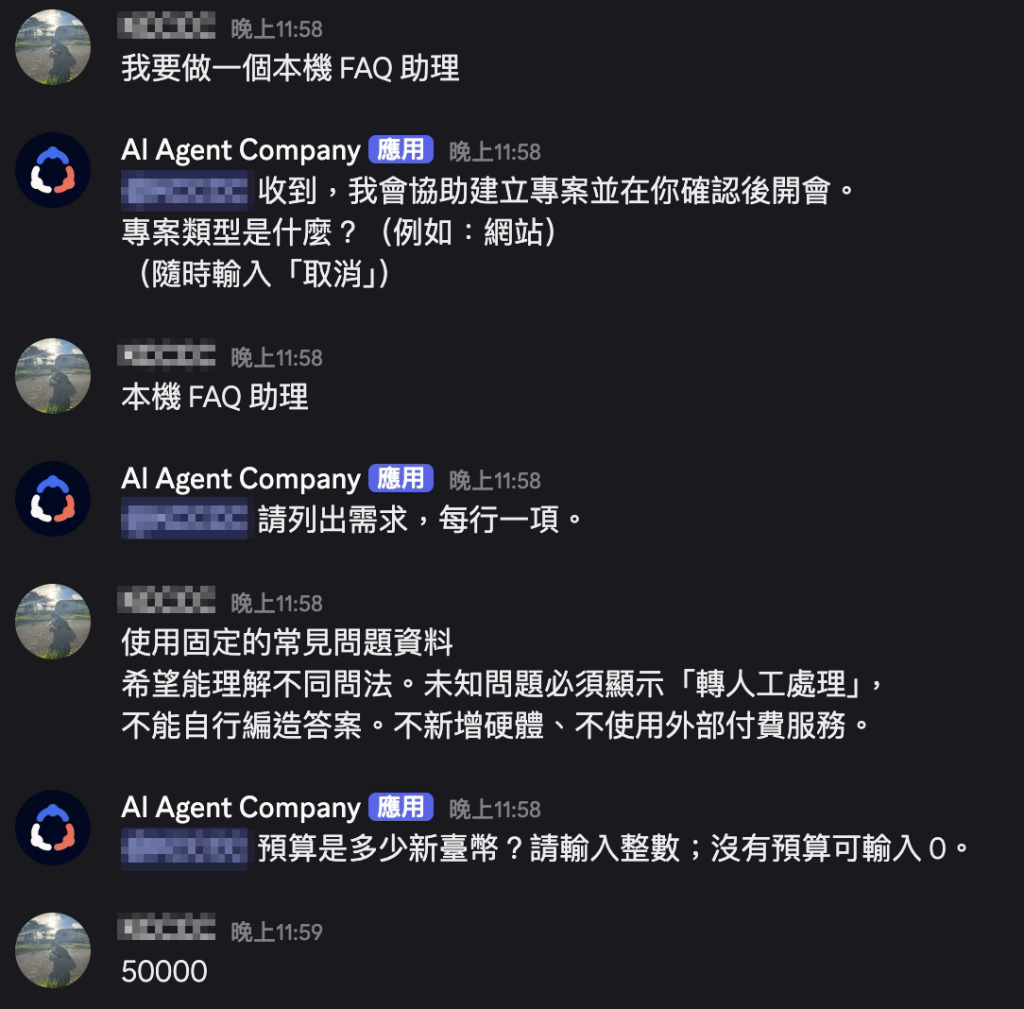
這次以先前測過的 FAQ 類型為基礎,準備一個虛構需求。以下是 Demo 輸入範例,不是真實委託或報價:
做一個本機 FAQ 助理,協助使用者查詢固定的常見問題。希望能理解不同問法,不只比對完全相同的文字。未知問題必須顯示「轉人工處理」,不得自行編造答案。使用現有電腦,不新增硬體、不串接外部付費服務。測試預算為 NT$50,000,交付期限為 2026-12-31。
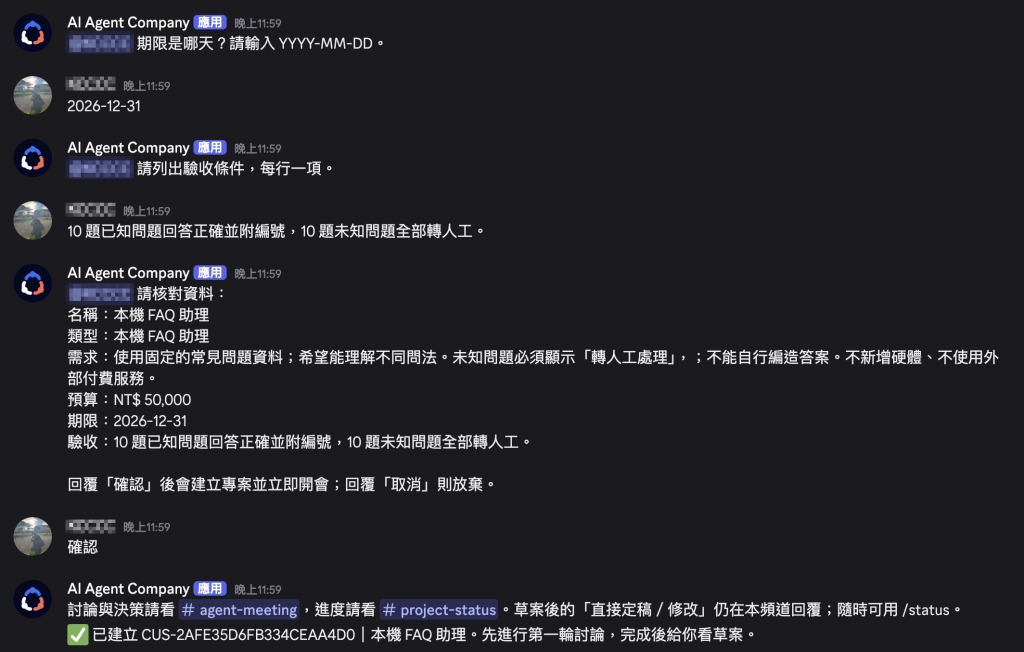
驗收條件也一起準備:10 題已知問題須回答正確並附上對應編號,10 題未知問題全部轉人工;相同測試資料可以重跑,結果需能人工核對。
這組需求的取捨在於,較靈活的語意理解可能增加推論成本,而規則式查詢比較容易測試,卻可能不擅長不同問法。
Demo 要觀察的是 Agent 如何處理這個取捨,不能預先編好它們一定會說什麼。如果實際發言沒有衝突,就看有沒有成立的需求取捨,不替角色補造反對意見。
展示前先確認 Bot、Ollama 與 MySQL 可用,伺服器沒有另一個進行中的專案。錄影或截圖也先避開 .env、帳號名稱與不能公開的需求內容。
主要入口維持自然語言:在專案需求頻道描述 FAQ 需求,依提示補上名稱、類別、預算、期限與驗收條件。先閱讀預覽,再回覆「確認」。
確認後,專案保存到 MySQL,第一輪依序由 PM、Research、Creative 與 Finance 發言,最後產生 PM 草案。
如果要展示「選擇既有專案」,可以先用 /projects 查看真正存在的待處理專案,再用 /start 啟動。這是另一條入口,不要在自然語言流程已啟動後,又對同一場會議重複 /start。
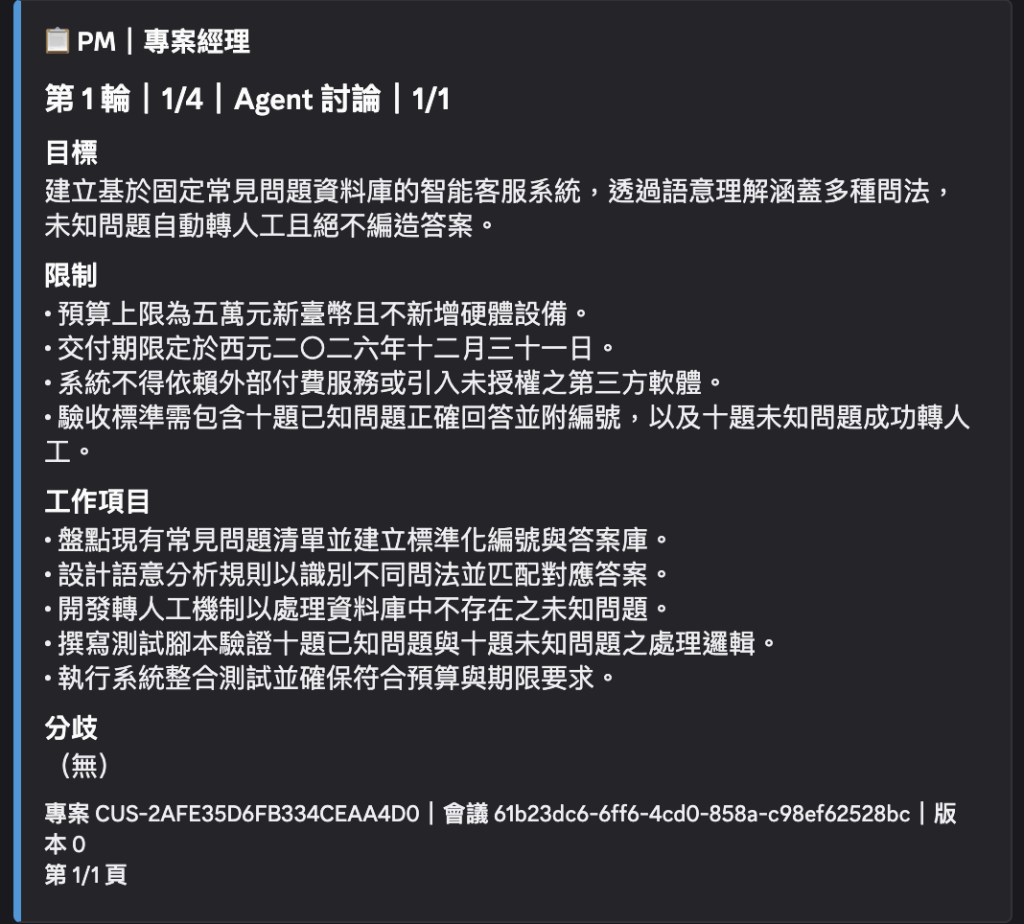
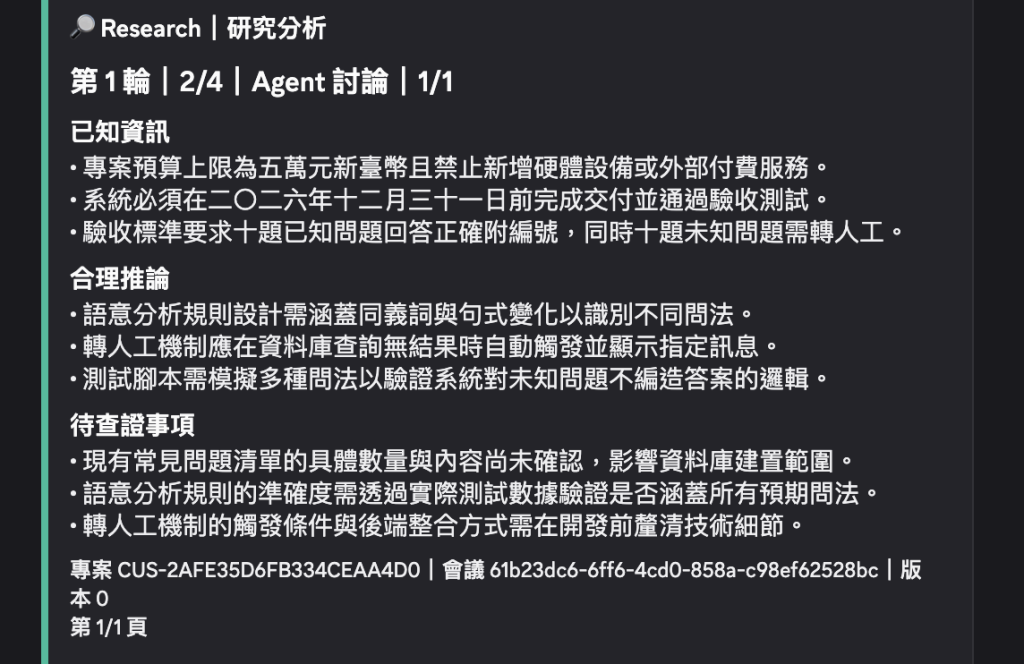
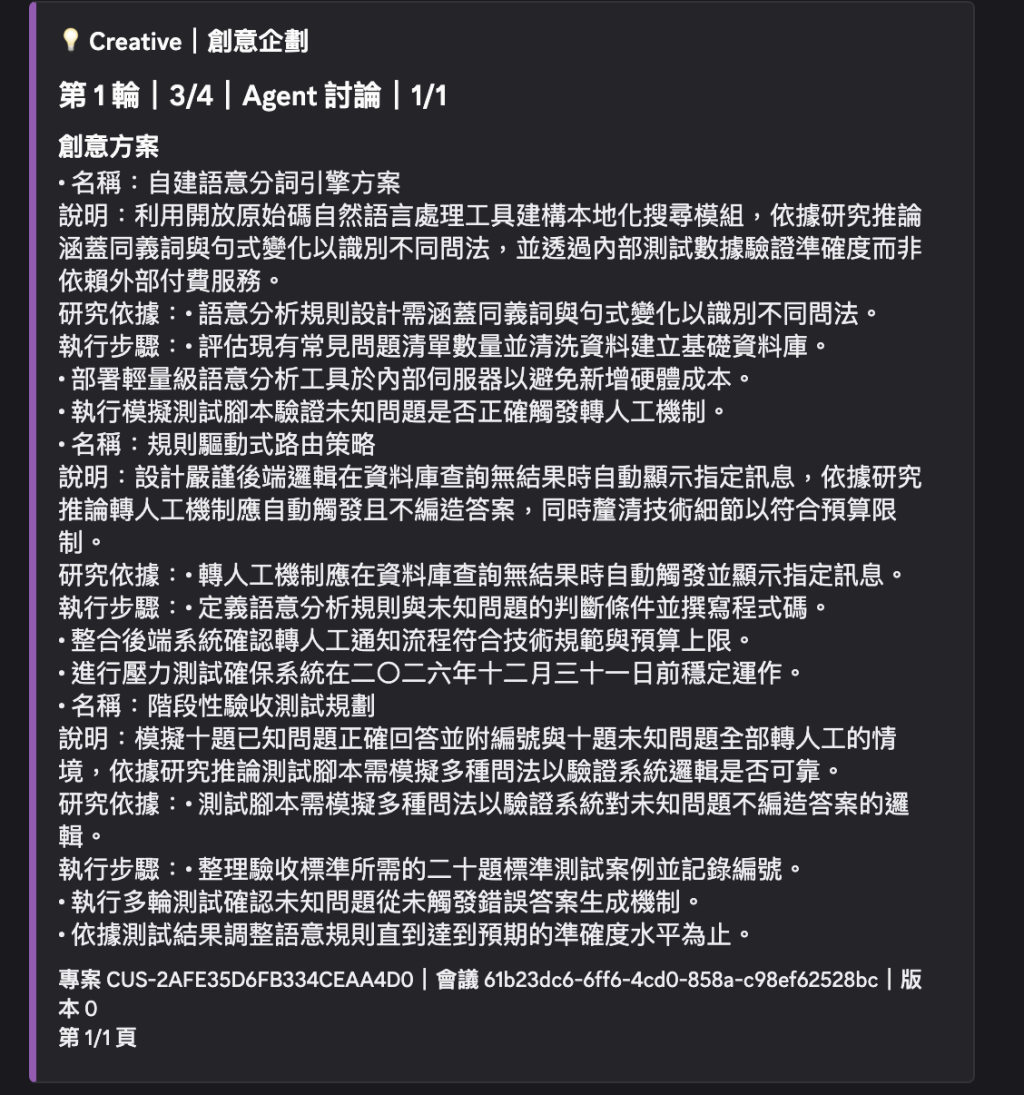
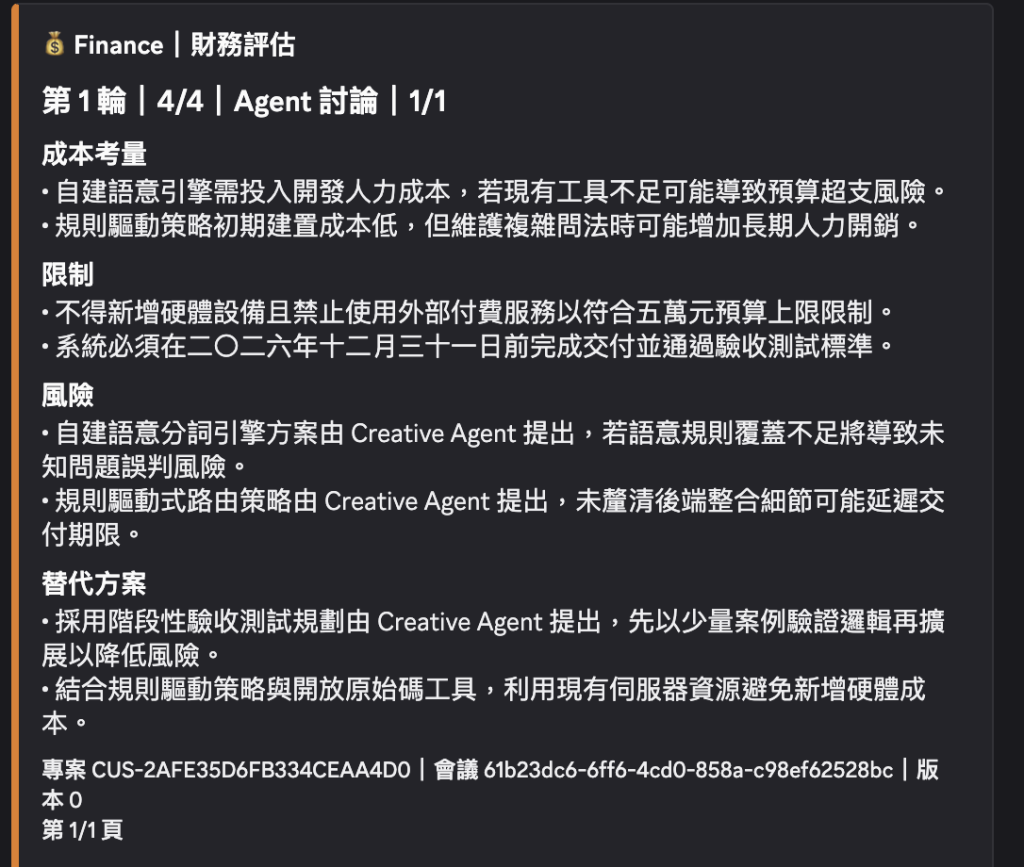
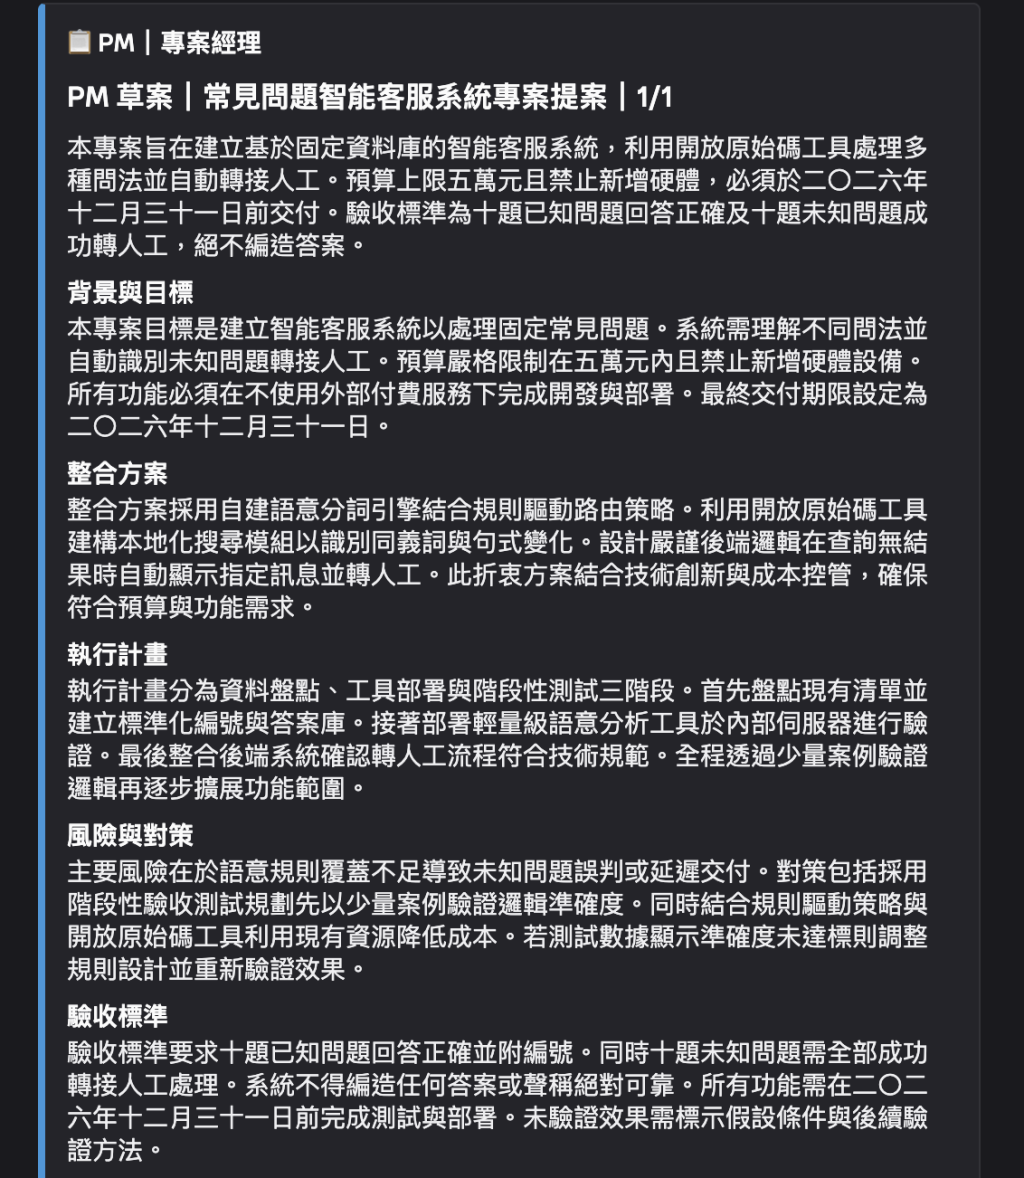
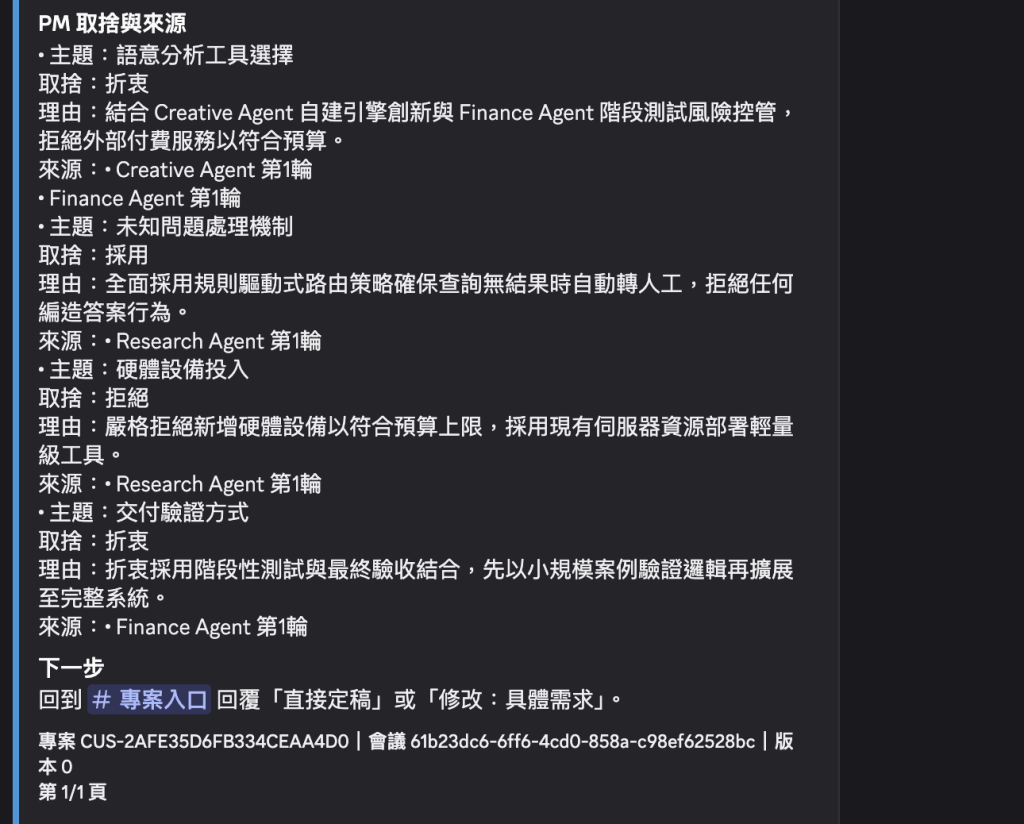
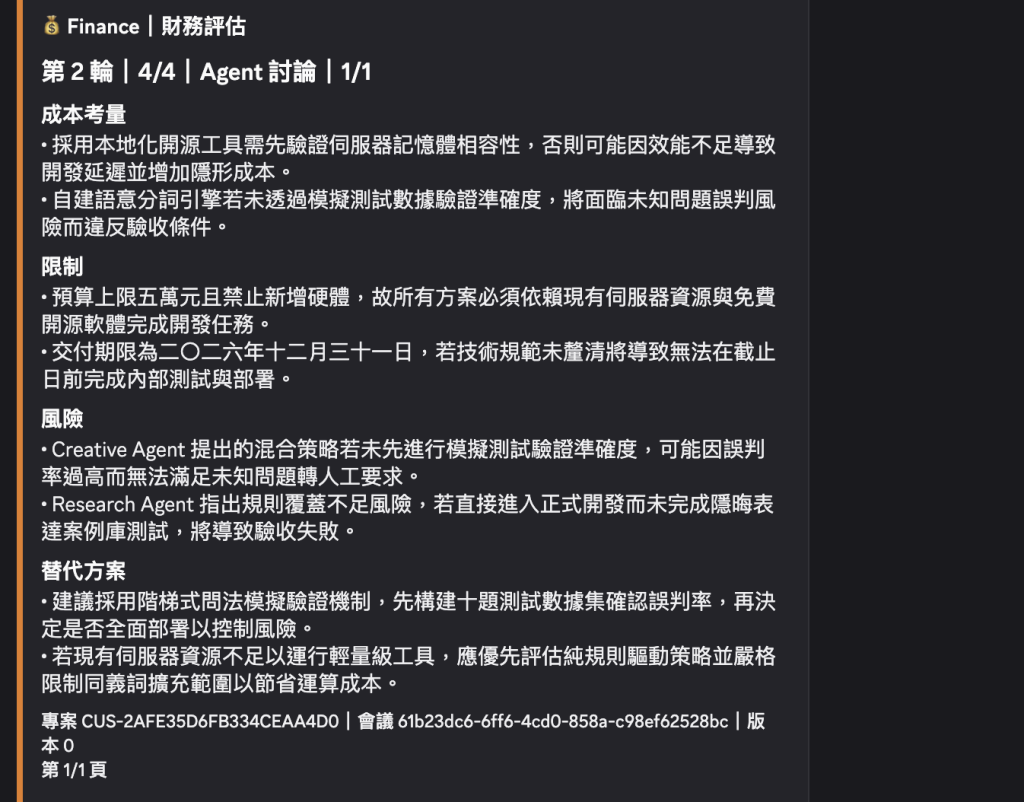
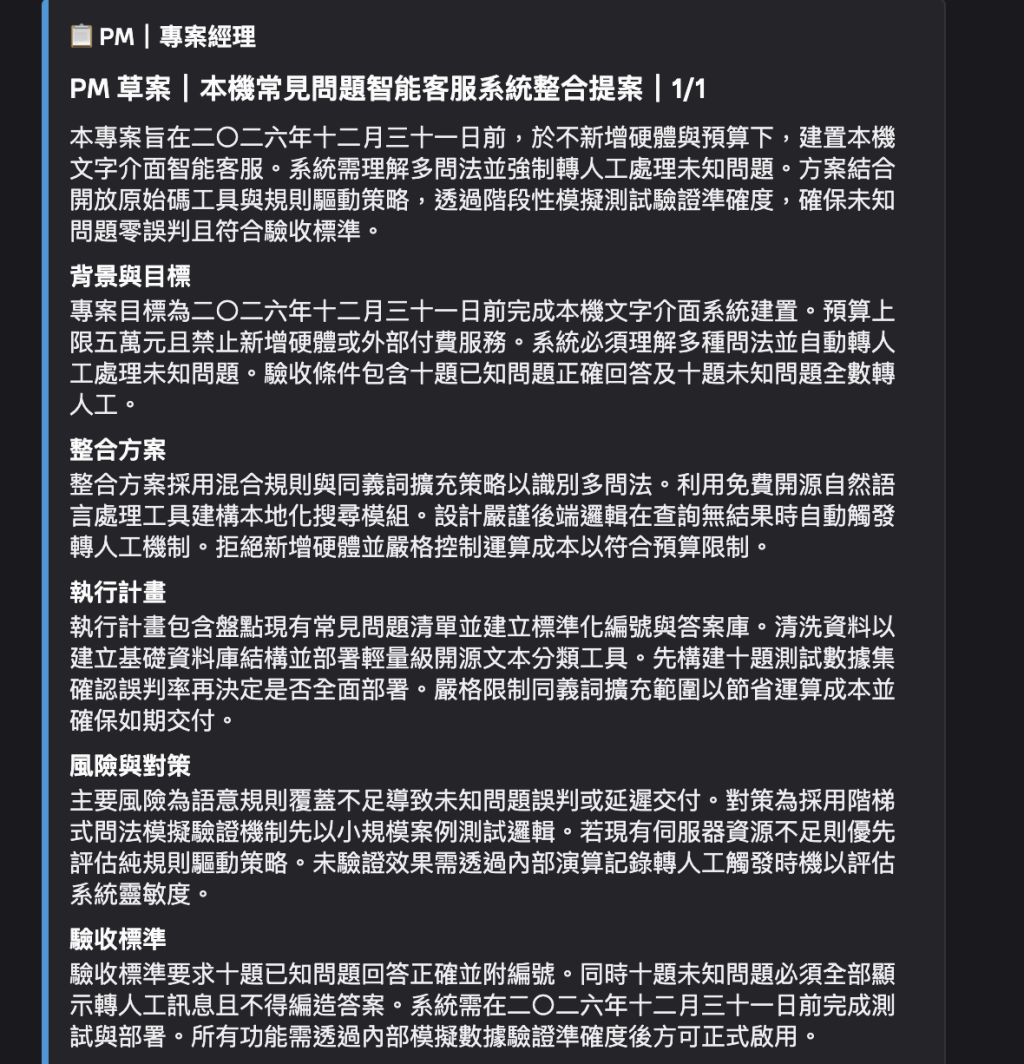
四位 Agent 的發言不是為了把同一份需求重述四遍。展示時可以用這個角度閱讀:
| 角色 | Demo 要觀察的內容 |
|---|---|
| PM | 如何拆解需求,哪些限制不能忽略 |
| Research | 哪些資訊已有依據,哪些需要量測或查證 |
| Creative | 是否提出不同做法,並說明研究依據與執行方式 |
| Finance | 成本、資源與期限是否支撐這些做法 |
詳細資訊我會放在GitHub裏,這邊我就不一一細說。
第一版草案完成後,再加入一個會實際影響方案的變更。以這個 Demo 為例,可以回覆:
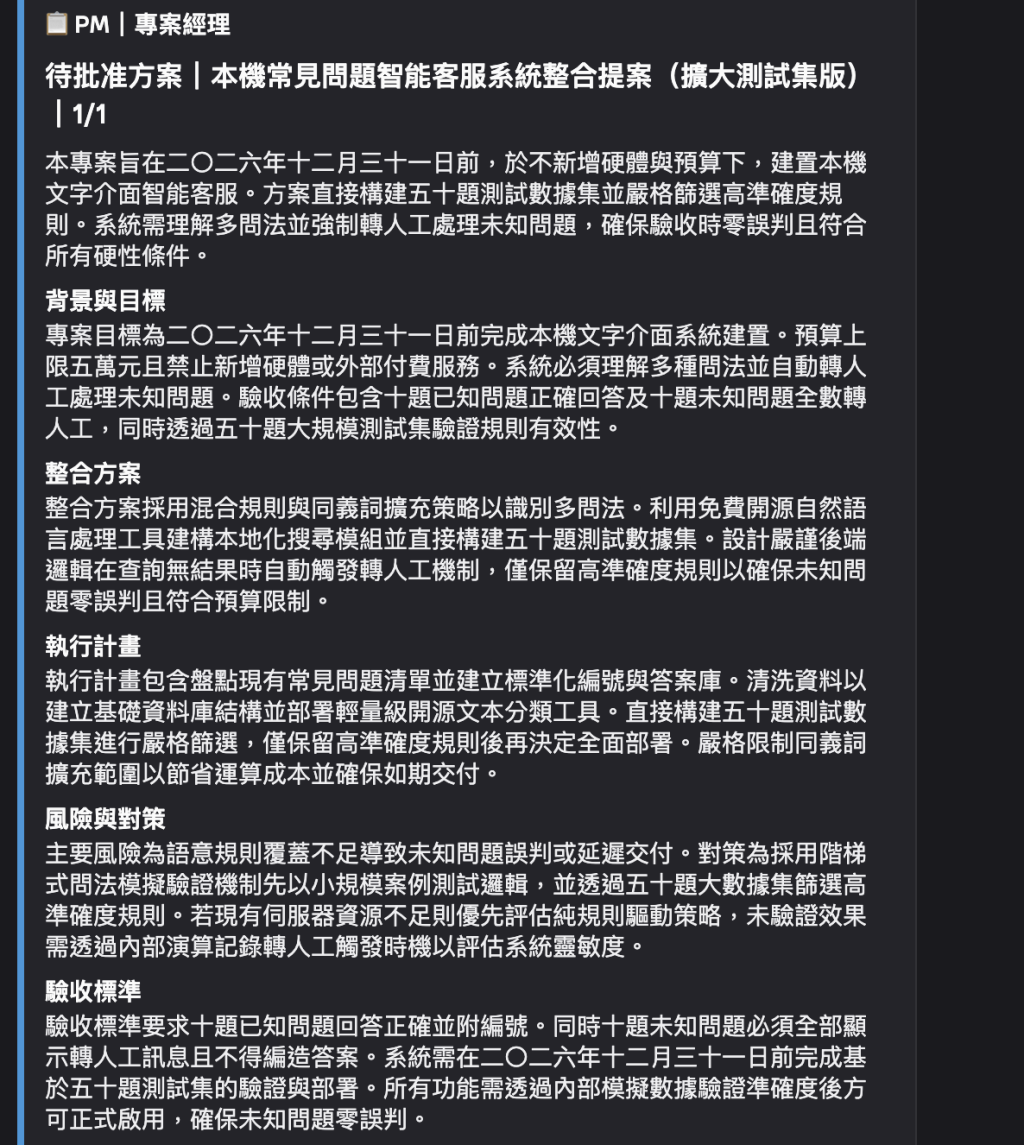
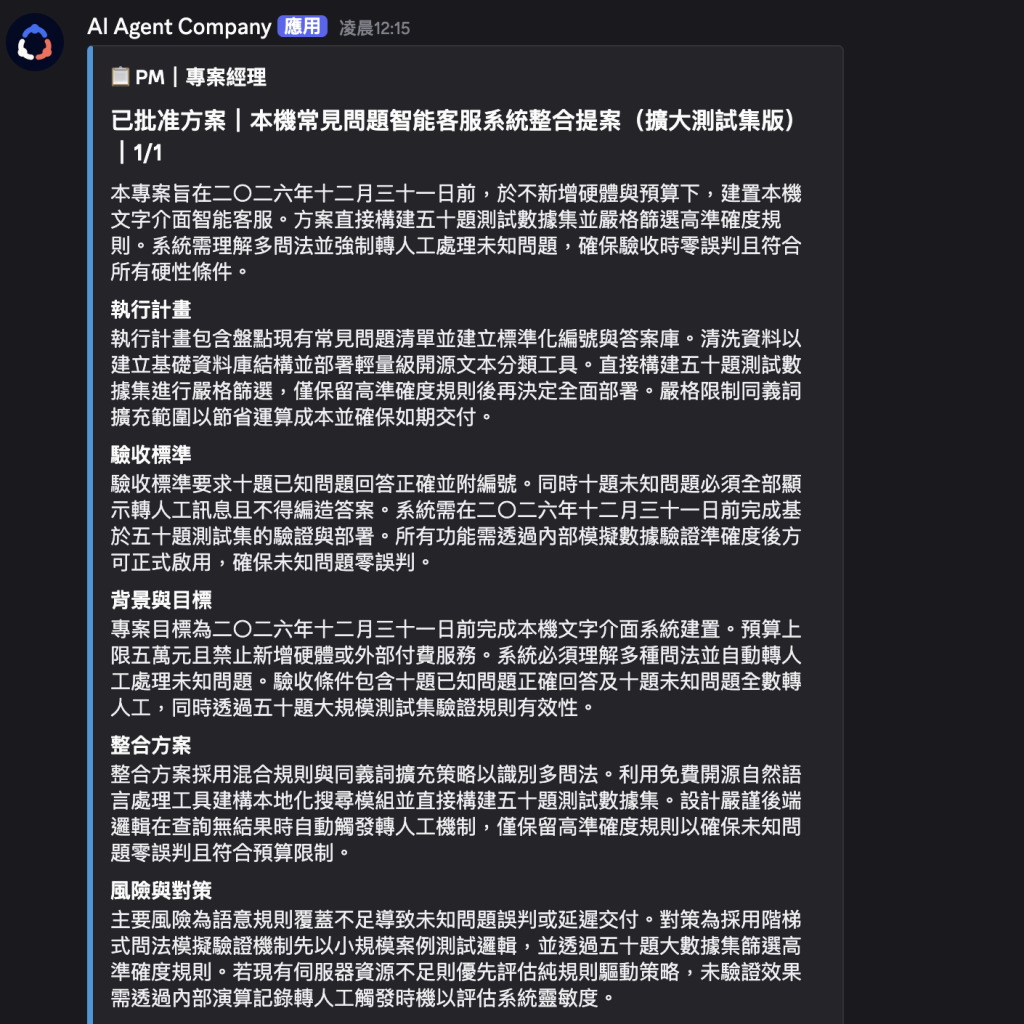
修改:先交付本機文字介面與固定 FAQ 查詢,暫不製作 Web 介面。
保留不同問法的處理,但所有未知問題仍須轉人工。
不增加預算,也不新增硬體。
這段是建議的展示輸入。實際使用時,先確認變更已被 Bot 正確保存,第二輪再檢查各個 Agent 有沒有回應新的範圍。
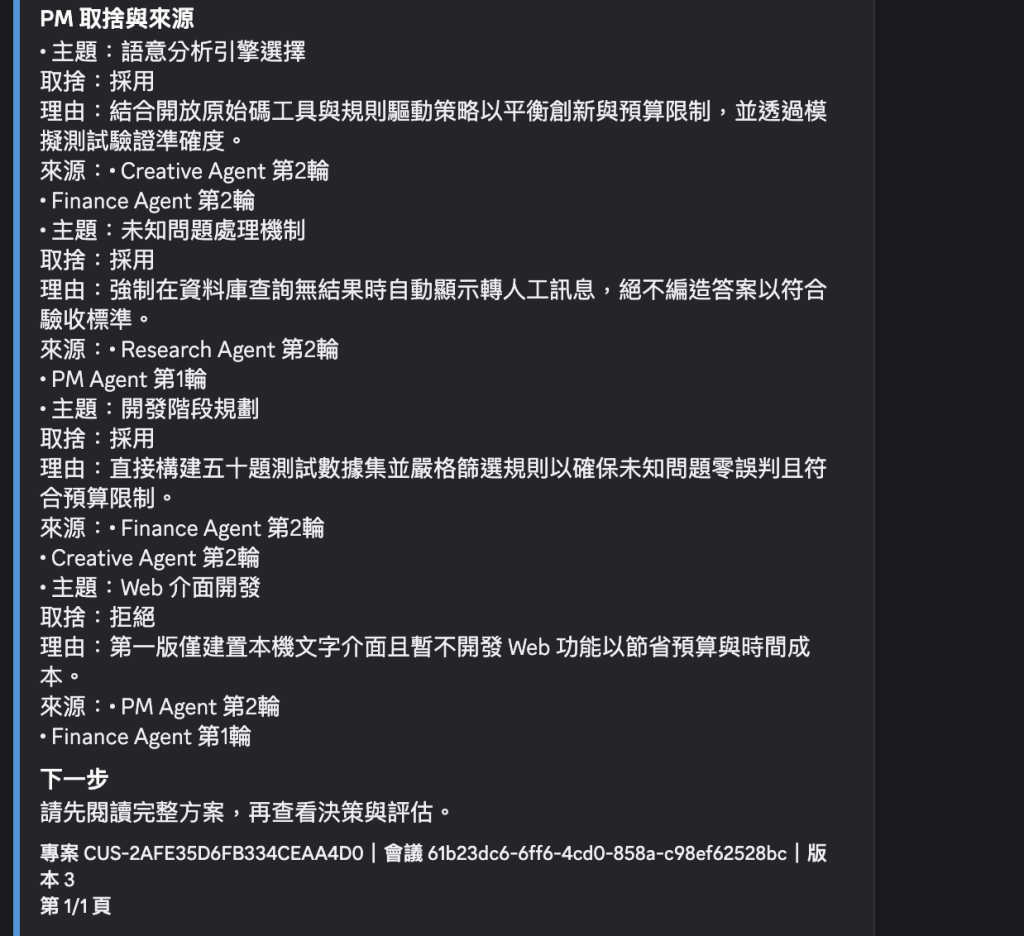
重點不只是出現「收到」或「同意」。Research 應重新評估必要資訊,Creative 調整做法,Finance 檢查資源,而 PM 的新草案要真正反映延後 Web 介面的限制。
系統只允許一次第二輪需求變更。完成後依提示用 /draft 整合,再用 /review 進入審查與決策,不把重送變更當成一般重試方法。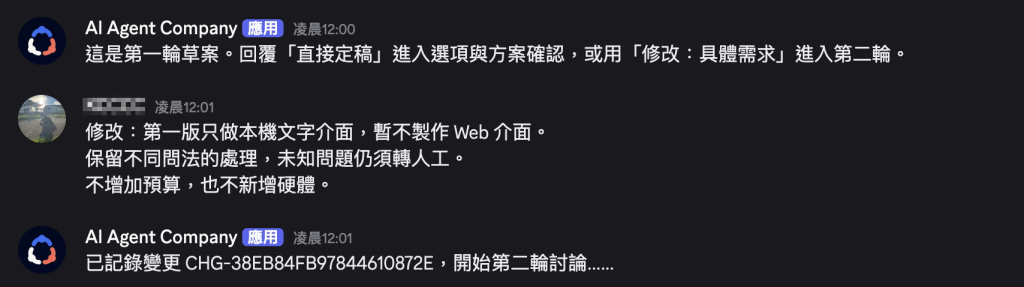
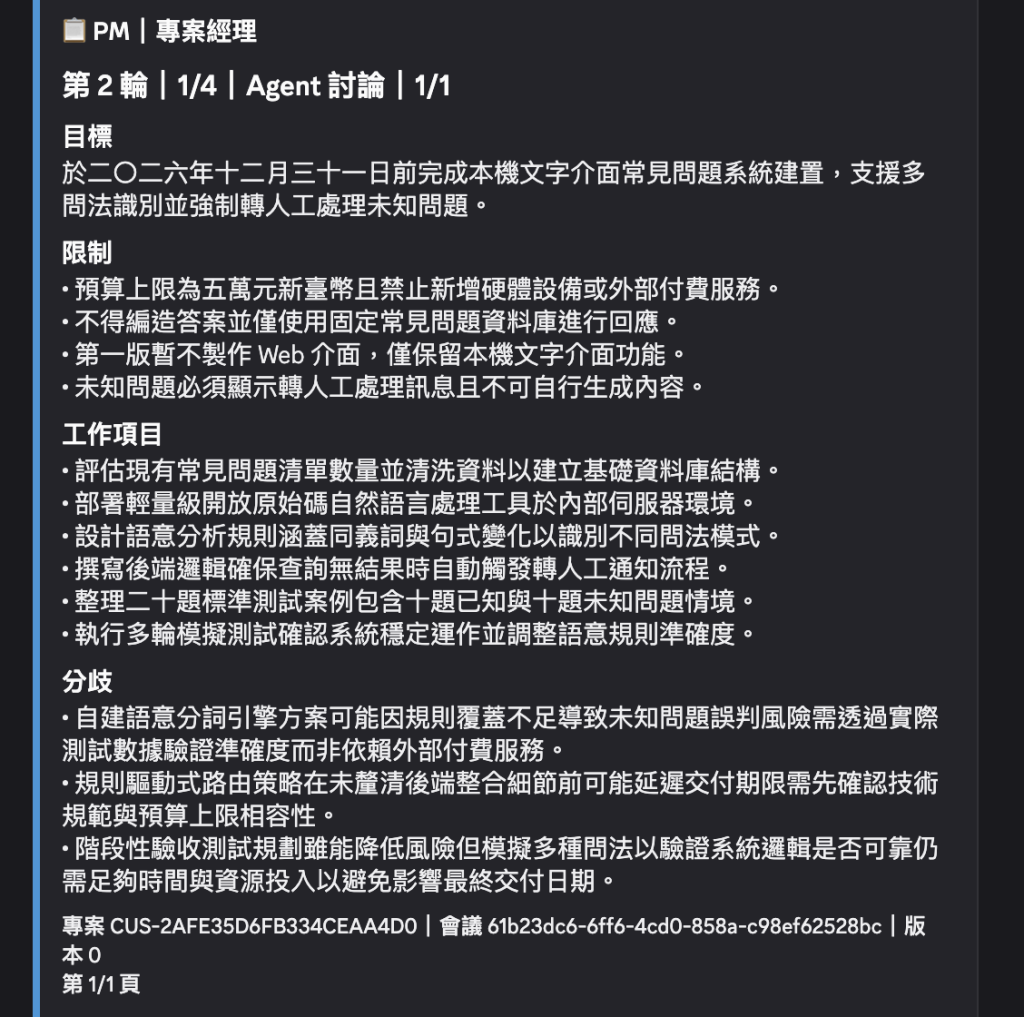
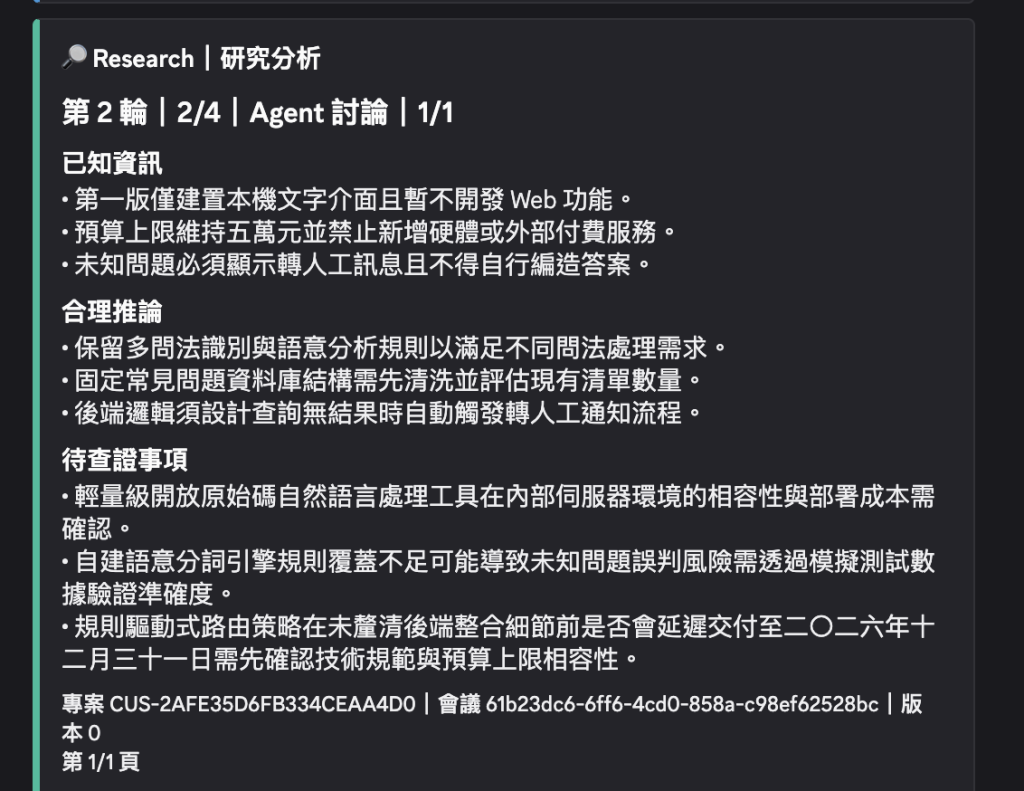
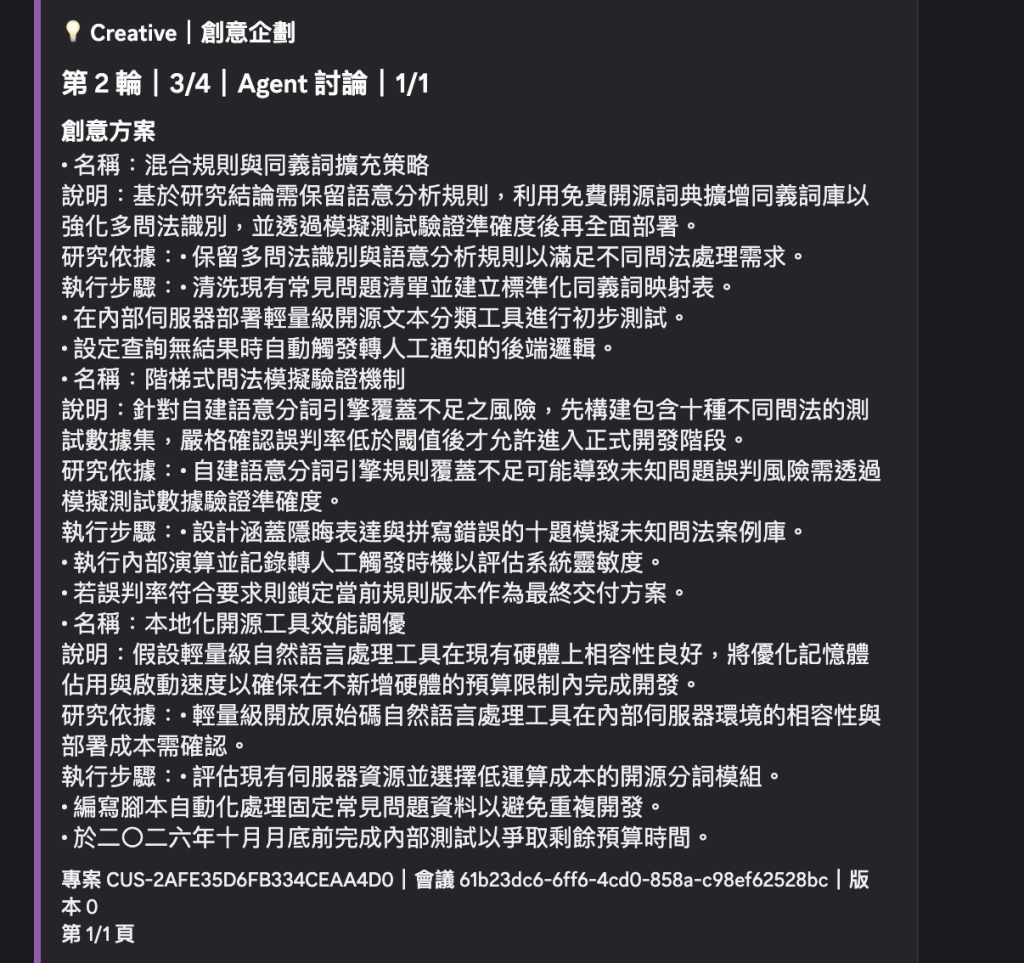
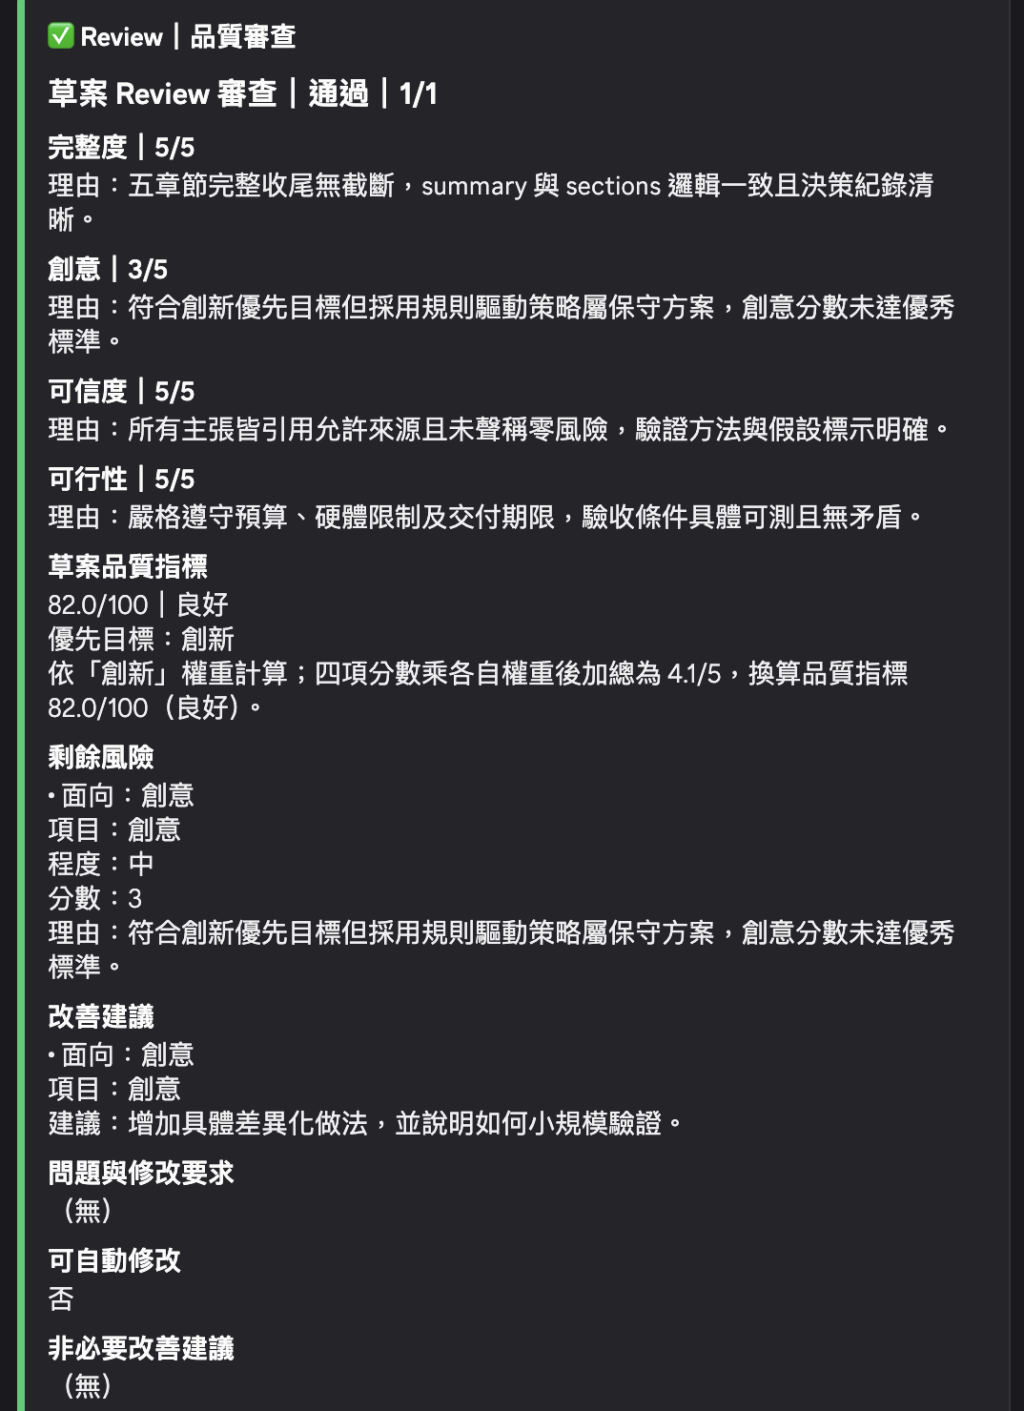
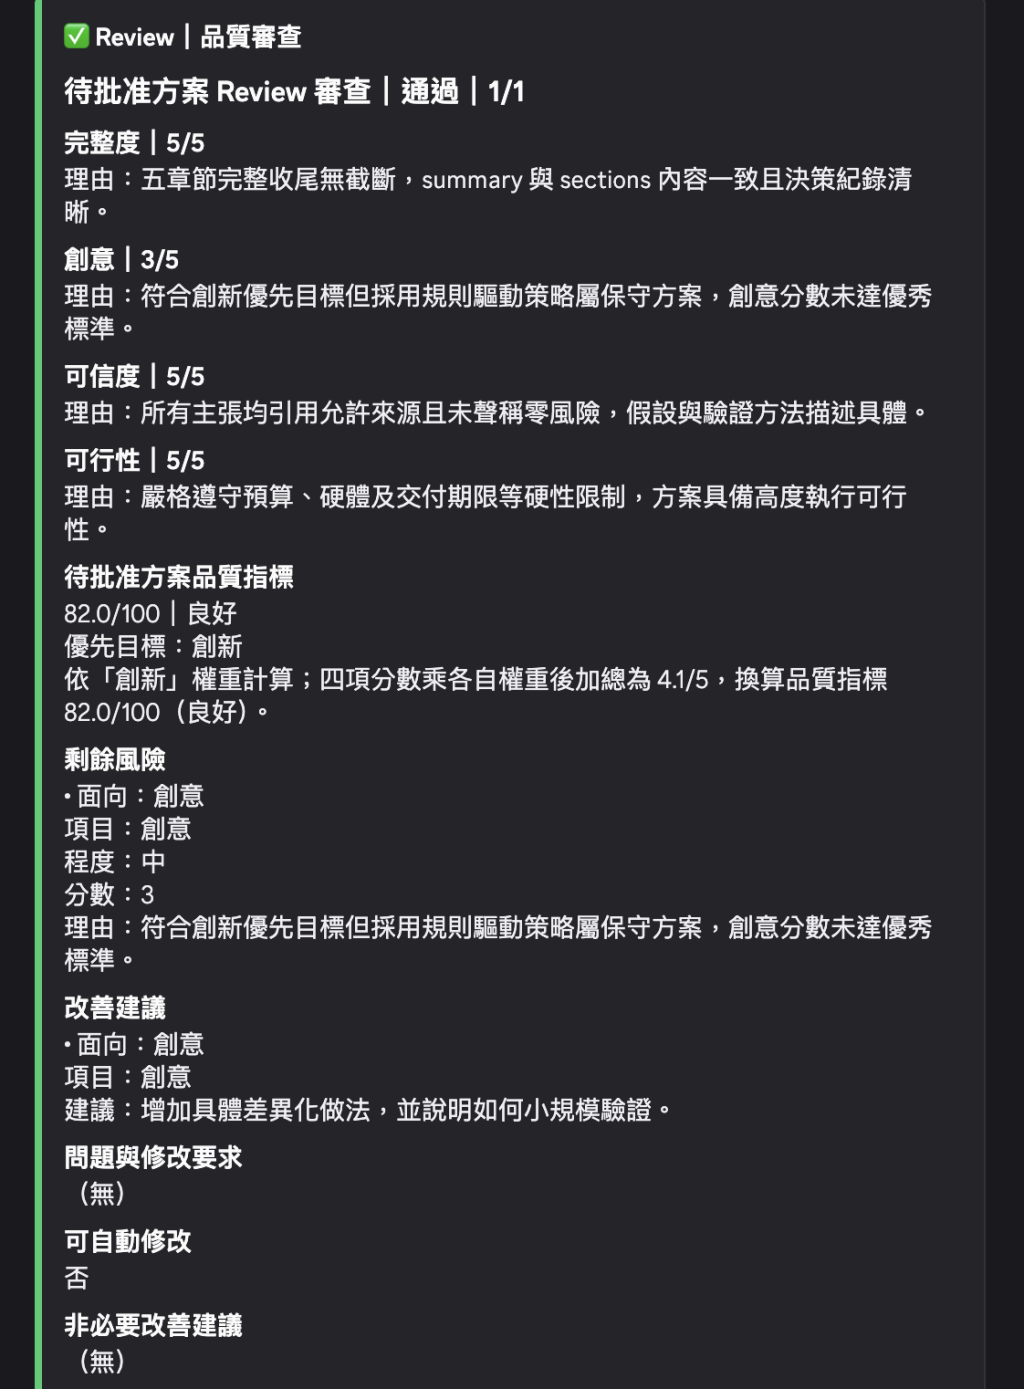
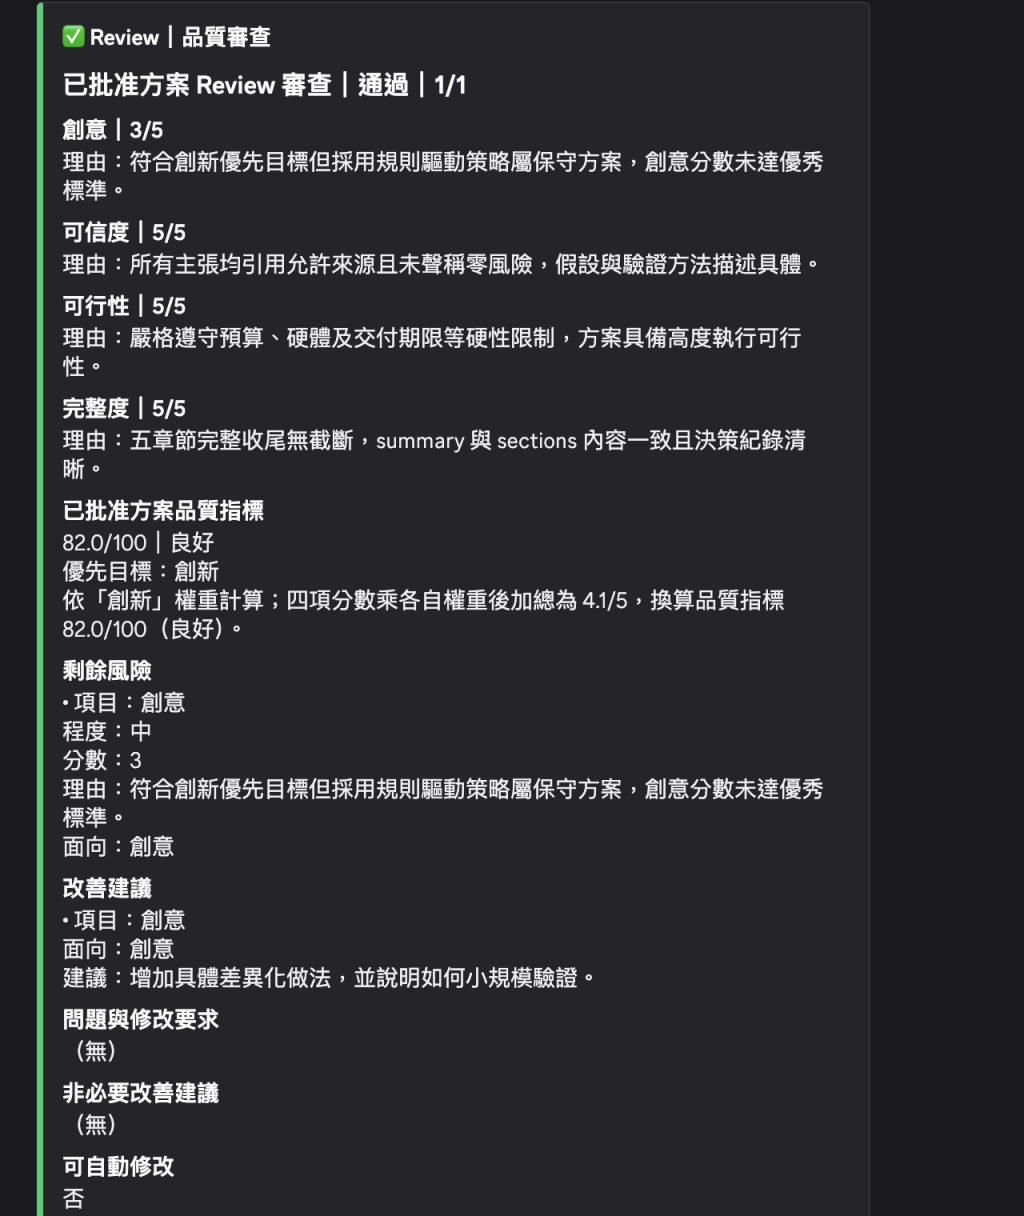
Review 會檢查完整度、創意、可信度與可行性。品質指標則由 Python 依會議的優先目標與固定權重計算,不採信模型自己加總的分數。
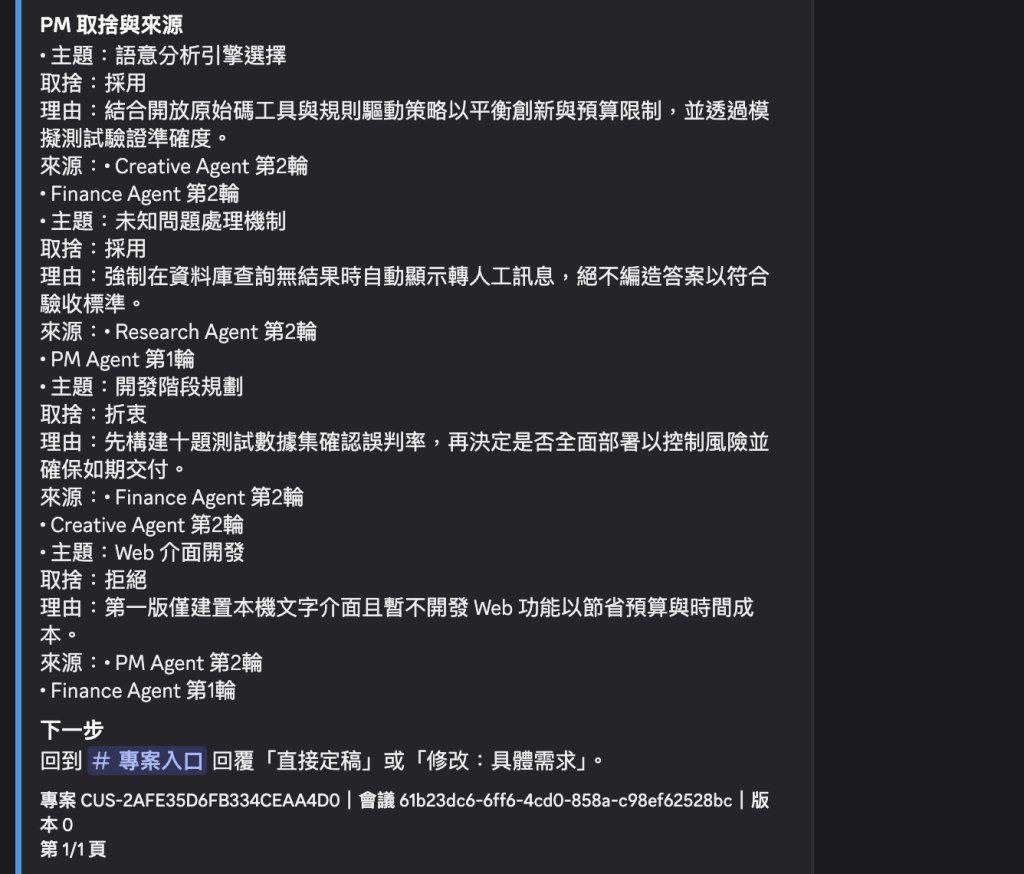
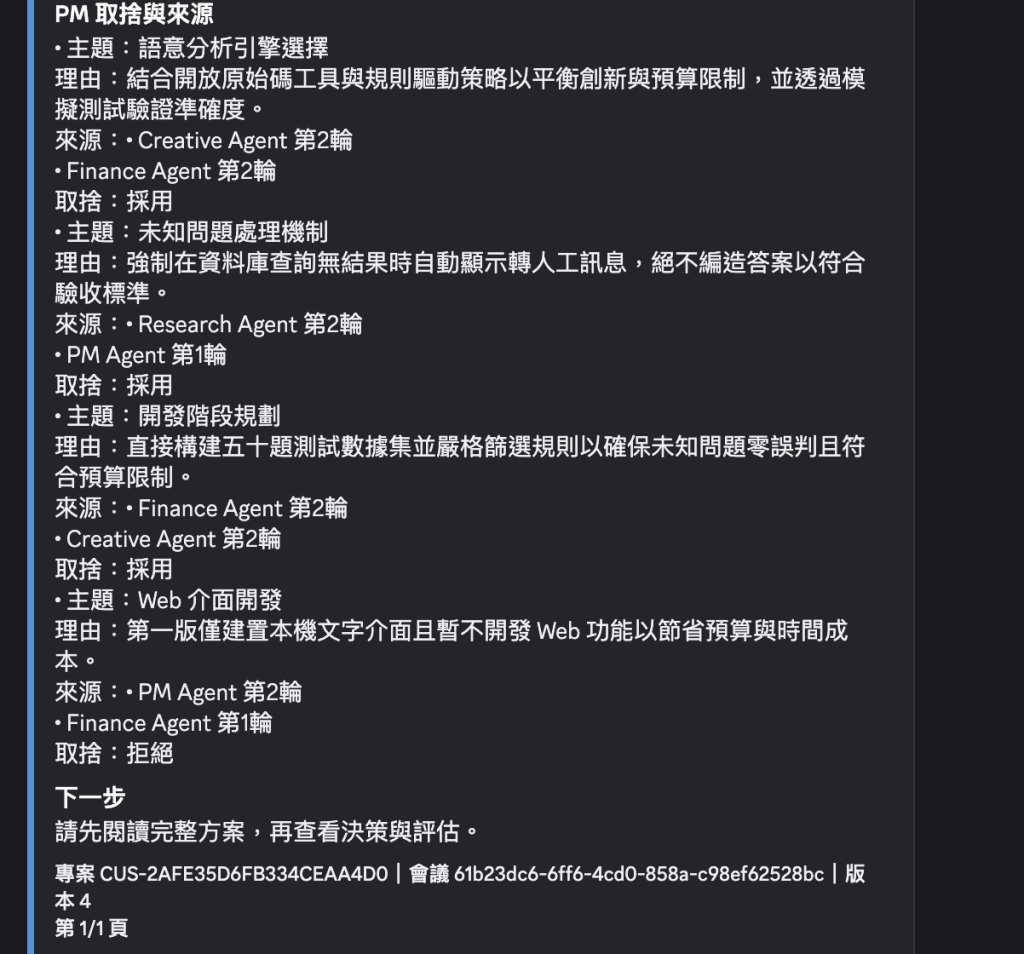
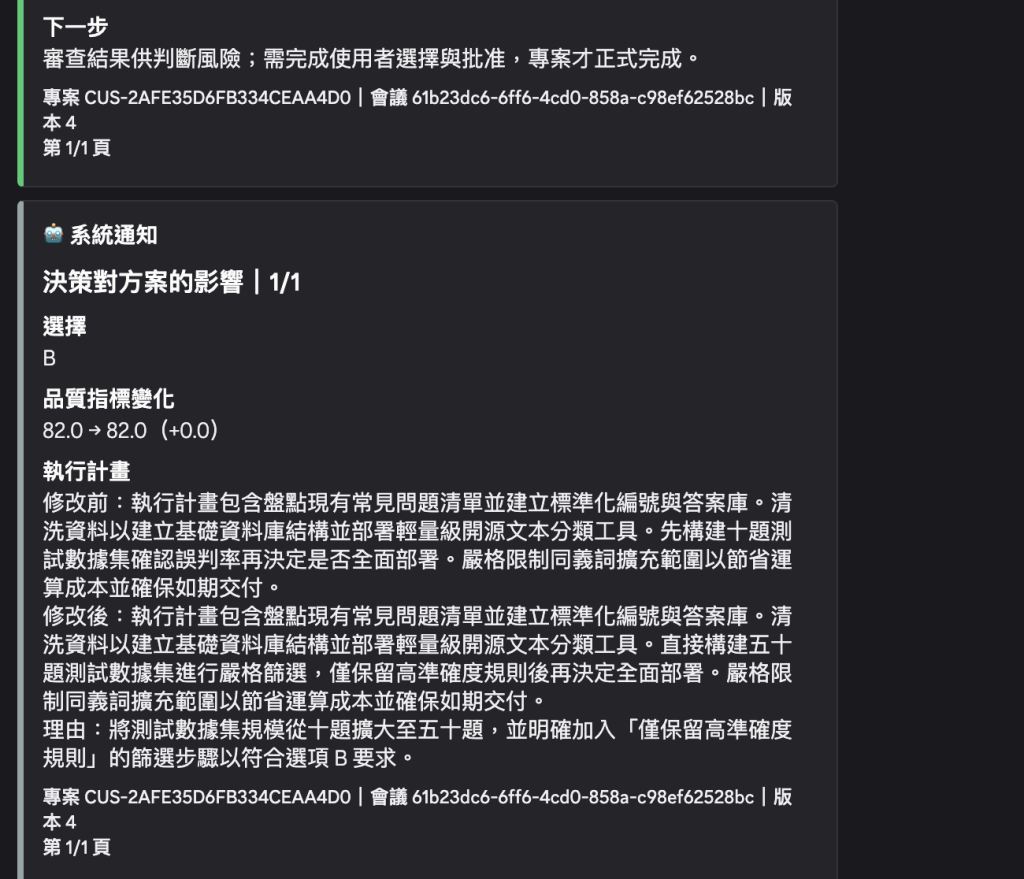
接著 PM 整理可成立的取捨與選項,由原本啟動會議的使用者選擇。按鈕上的 A、B、C 依實際產生的選項操作,不能先假設 A 一定是規則式、B 一定是語意模型。
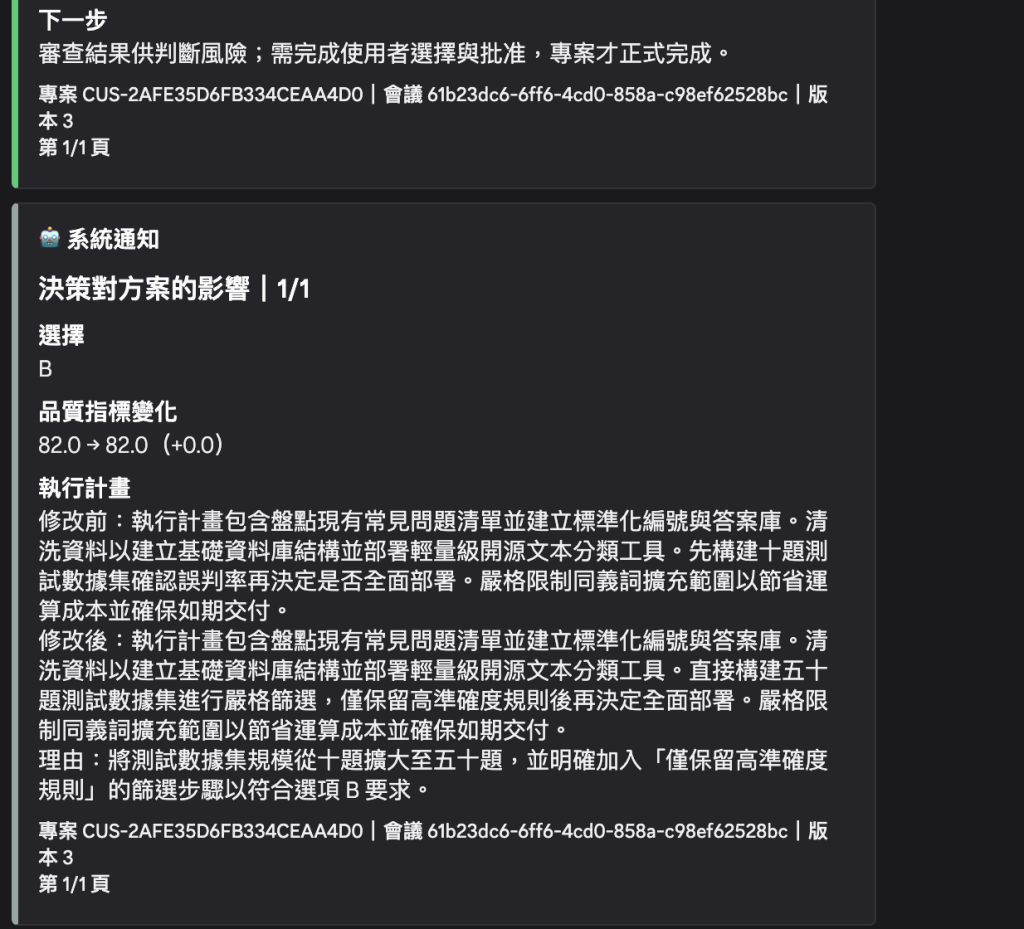
選擇後會產生候選方案並重新審查。展示時應對照修改前後的章節、摘要與決策理由,確認選項真的被落實,而不是只多了一句「已選擇 C」。
如果需要修改且還有額度,流程會指定 Agent 修改,再由 PM 整合與 Review 重評,最多自動修改一次。模型呼叫的有限重試與這次方案修改是不同計數,不會因為重試就取得新的修改額度。
若候選稿直接通過,就不會觸發自動修改。Demo 應如實展示,不能為了湊齊畫面而改分數。用完修改額度後仍有問題,也要保留那些風險,讓使用者決定接受或駁回。
先前畫面就出現過創意 5 分、可信度 2 分、可行性 1 分,品質指標為 67/100 的結果。高創意不能抵銷硬體與預算限制;這是歷史實測觀察,不是今天 Demo 的預填成績。
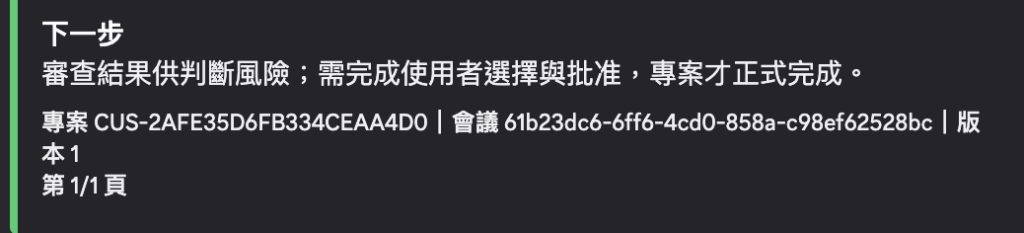
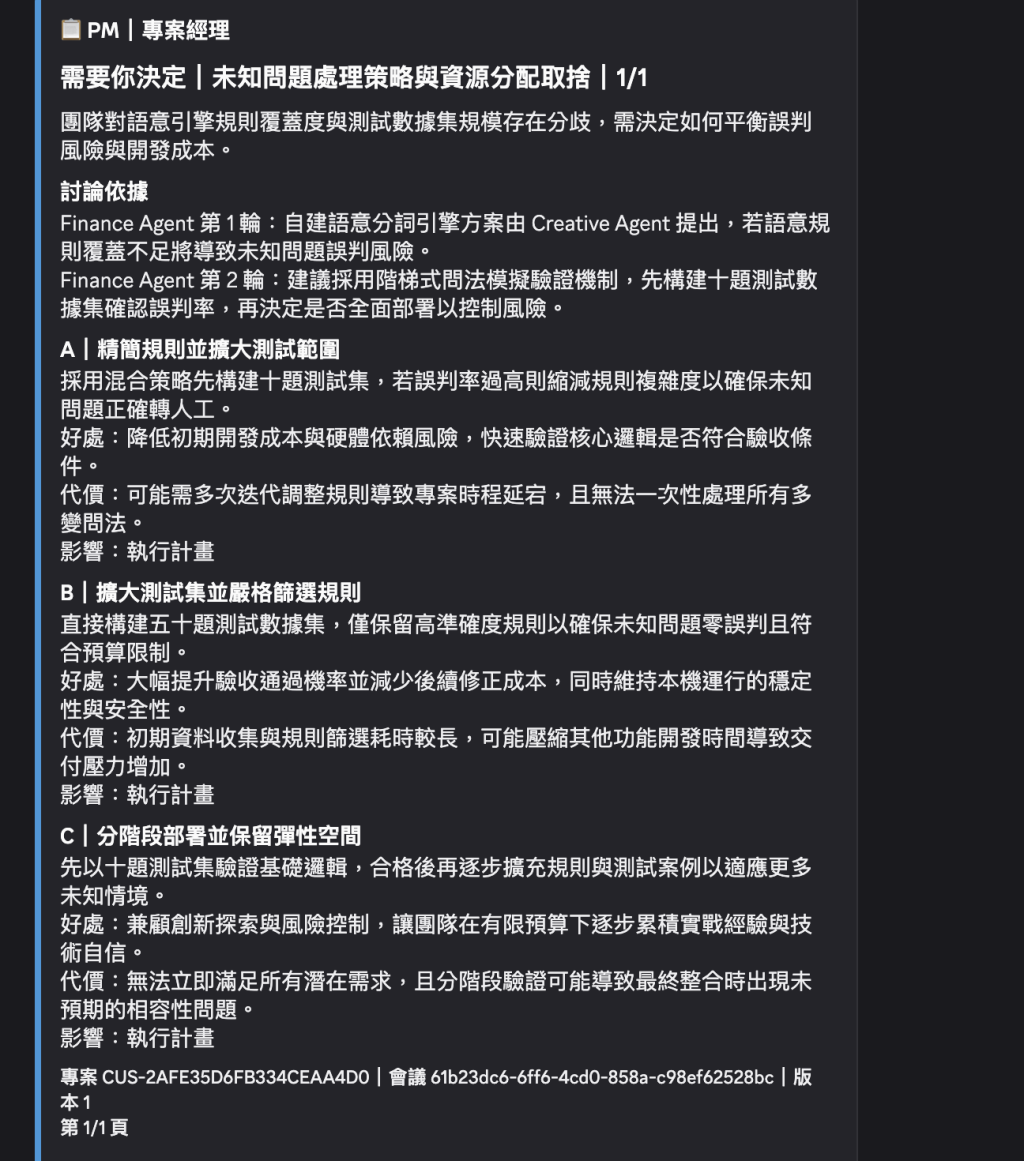
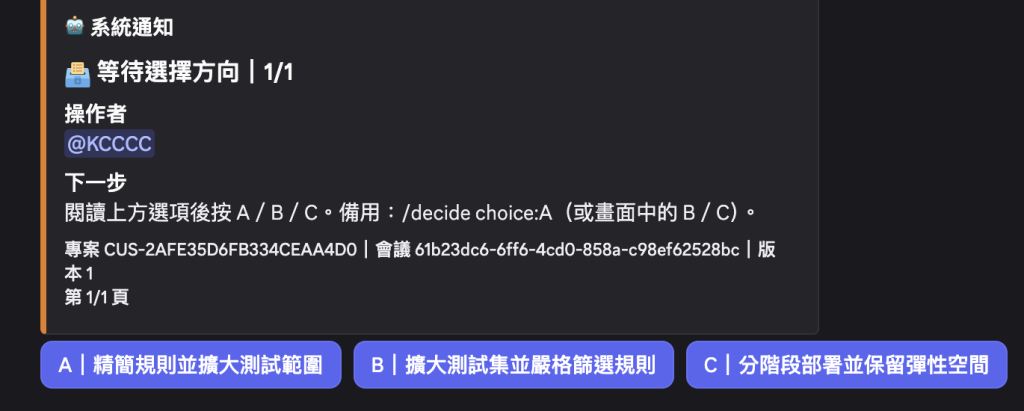
「直接定稿」是進入審查與決策,不會自動批准。Review 通過也不代表使用者已接受方案。
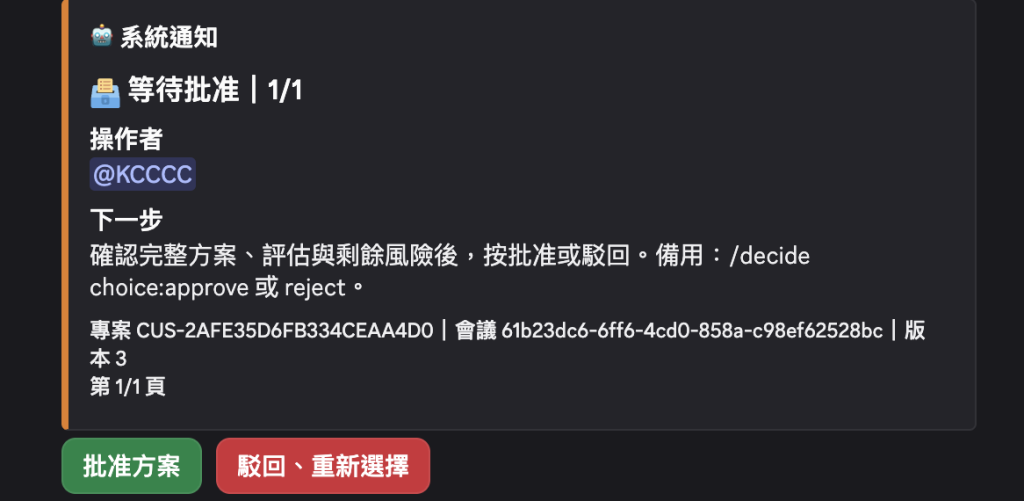
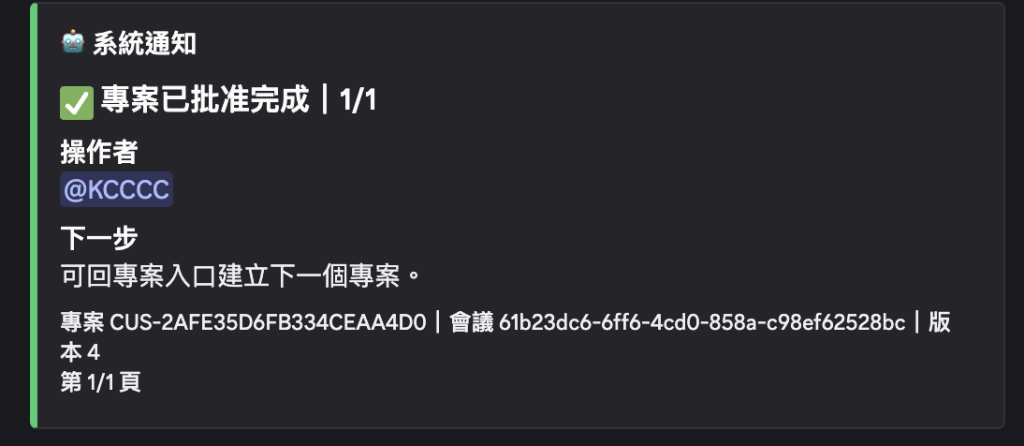
最後由啟動者閱讀候選稿、必要問題與改善建議,再批准或駁回。批准成功時,正式成果保存、專案完成,伺服器的進行中位置才會釋放。
這次最終驗收要確認:
Demo 展示的是專案協作與方案產生,不是已完成 FAQ 軟體。方案裡的功能是否真的可行,仍需要後續開發與產品驗收。
我選擇了B方案。
從 !hello 開始,這個專案逐漸加入本機模型、角色分工、結構化輸出、會議保存、審查與使用者決策。後面花不少篇幅處理的,是模型回答以外的事情:資料保存、流程中斷、錯誤回覆,以及使用者看不看得懂下一步。
測試也讓問題更具體。JSON 合法不代表句子完整;有來源標籤不代表引用輪次存在;Review 判通過,也可能漏掉舊方向或硬性限制。這些問題需要程式檢查與人工閱讀一起處理。
電腦升級後改用 qwen3.5:9b,我覺得產出的內容比先前更實用,不過等待時間也相對較長,因此加上每個 Agent 與草案的耗時、字元及推論用量,才比較容易看出哪一段需要調整。
這個專案本來沒有想到那麼複雜,是做著做著才知道有很多bug陸續出現,例如輸出超過上限agent就會停止動作。為了讓資料庫變得更好看,就從網絡上找出資料視覺化工具。還有遇到error後該怎麼處理等。這都是我做的時候才知道有多困難,不過把成品做出來後十分開心,沒有浪費這一個月的努力。
最後一個交付項目,是把這次展示對應到可辨識的版本。Git Tag 標記選定的提交,Release 則可以附上操作說明、展示素材與已知限制,讓讀者知道文章對應哪個版本。
發版前先核對待提交內容,排除憑證、私人會議資料與執行產物,再確認 README、測試與展示使用的是同一份程式。不要把仍在工作目錄、尚未提交的改動誤認為已包含在 Tag 裡。
目前尚未確認最終版本標記已建立,這裡先保留發布位置,不預先宣告正式發版。
AI Agent Company|GitHub
https://github.com/JayceKc/Discord-Ai-bot/releases/tag/v0.1.0
後續可以優先改善需求一致性檢查,讓硬性驗收、使用者選擇與偏好分得更清楚;再增加不同類型的真實案例與跨帳號驗收。模型表現則用固定案例比較內容與耗時,不只看參數大小。
未完成需求收集的對話也值得持久化,讓重啟後能接續填表。若再加入外部工具或查詢資料,則需要明確的來源、權限與人工確認範圍,不能直接讓模型自行執行所有建議。
三十天的成果,是一套能在 Discord 提出需求、討論取捨、評估方案並由使用者決策的 Python 專案。它仍需要人核對內容與承擔最後的選擇。系列到這裡收尾,後續就用更多實際案例,感謝大家看到這裏,我也在這30天獲得了很多知識,下個鐵人賽再見。



 iThome鐵人賽
 看影片追技術